Notizen lokal speichern: Ordner statt Datenbank
Wir haben ein Notizsystem gebaut, in dem eine KI mitschreibt, umräumt und Sprachnachrichten zusammenfasst. Die wichtigste Entscheidung dabei war keine KI-Frage, sondern eine ganz alte: Wo liegen die Daten? Unsere Antwort: in normalen Ordnern, auf deinem Rechner.
Worum es geht
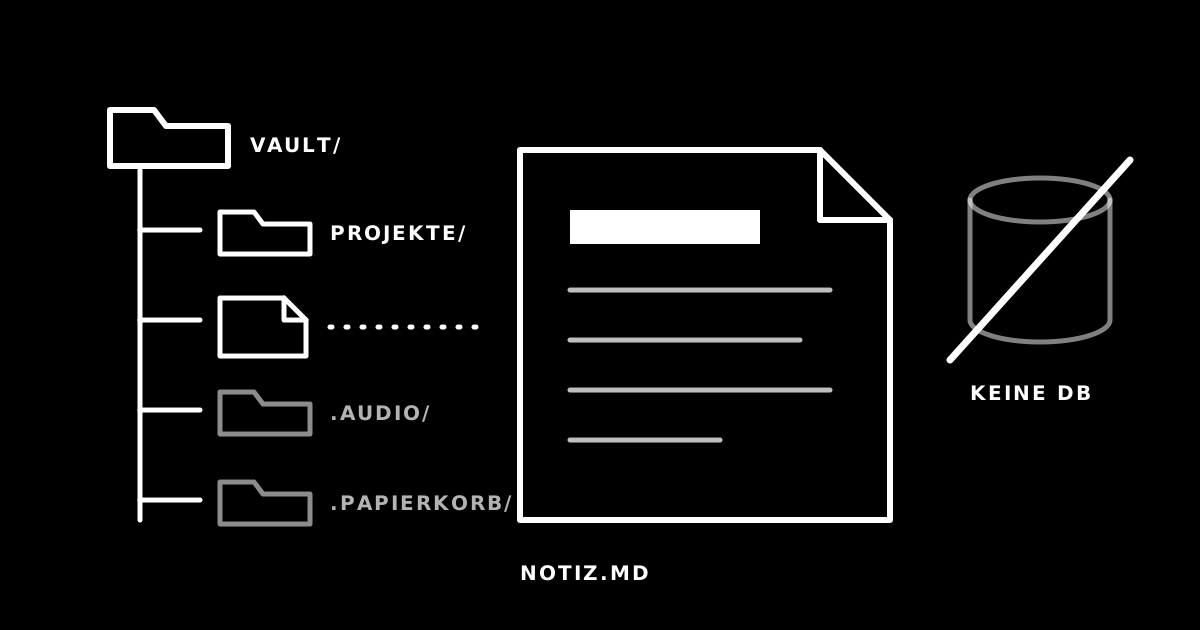
kontext ist unser Notizsystem im Browser. Links ein Ordnerbaum, rechts die Schreibfläche, unten eine Zeile für das Alpaka. So heißt der KI-Agent, der Ordner und Dateien lesen, schreiben und verschieben kann. Ein Kreis daneben nimmt Sprachnachrichten auf. Das Alpaka fasst sie zusammen, ordnet sie Projekten zu und legt Erinnerungen an, die als Web-Push kommen.
Sobald eine KI selbst Dateien anlegt und überschreibt, wird Speichern zur Vertrauensfrage. Du willst wissen, wo deine Gedanken liegen, ob du sie wiederbekommst und wer sie sieht. Deshalb steht hier nicht, was kontext alles kann, sondern wie es speichert.
Der Vault ist ein Ordner
Alles, was du in kontext schreibst, landet im Vault. Das ist ein ganz normaler Ordner mit echten Unterordnern und .md-Dateien. Ein Ordner in der Seitenleiste ist ein Ordner auf der Festplatte. Eine Notiz ist eine Markdown-Datei. Die erste Zeile der Notiz wird ihr Dateiname. Wer „# Anruf mit Linda“ schreibt, bekommt Anruf mit Linda.md.
So sieht ein Vault aus:
vault/
├── _ki.md                      Regeln für die KI, gelten überall
├── Inbox/
│   └── Anruf mit Linda.md
├── Projekte/
│   ├── _ki.md                  Regeln nur für Projekte/ und darunter
│   └── Website/
│       └── Ideen.md
├── .audio/                     Sprachnachrichten: Audio + wörtliches Transkript
│   ├── 2026-10-27-09-15-02.webm
│   └── 2026-10-27-09-15-02.txt
├── .papierkorb/                Gelöschtes und alte Versionen
│   └── Ideen.md
└── .kontext/                   Erinnerungen und Push-Abos als JSON
    ├── erinnerungen.json
    └── push-abos.json

data/                           außerhalb des Vaults
└── VAPID-Schlüssel für Web-Push
Die Ordner mit Punkt vorne sind in vielen Dateimanagern ausgeblendet. Sie sind trotzdem da und genauso lesbar wie der Rest.
Regeln, die vererbt werden
Eine Datei _ki.md in einem Ordner sagt dem Alpaka, wie es dort arbeiten soll. Zum Beispiel: „Protokolle immer mit Datum, Teilnehmenden und offenen Punkten.“ Die Regeln gelten für den Ordner und alle Unterordner. Liegt in einem tieferen Ordner eine weitere _ki.md, kommt sie dazu. Das ist dasselbe Prinzip wie eine .gitignore oder eine CLAUDE.md: Konfiguration liegt dort, wo sie gilt, als Text, den man lesen kann.
Suche ohne Index-Datei
Gesucht wird mit BM25, einem klassischen Verfahren für Volltextsuche. Der Index liegt nur im Arbeitsspeicher. Er wird beim Start aus den Dateien gebaut und danach inkrementell aktualisiert: Neu gelesen wird nur, was sich laut Änderungszeit (mtime) geändert hat. Titel und Ordnernamen zählen dreifach, weil man sich an die meist besser erinnert als an einen Satz im Text. Für einige tausend Notizen reicht das. Der Index ist eine Ableitung, keine zweite Wahrheit. Ist er weg, baut kontext ihn neu.
Sprachnachrichten: erst sichern, dann denken
Bei Sprachnachrichten ist die Reihenfolge wichtig. Sobald du die Aufnahme beendest, schreibt kontext das Audio und das wörtliche Transkript als Log nach vault/.audio/, also eine Audiodatei und eine .txt daneben. Erst danach läuft die KI. Fällt die Verbindung zur API aus oder macht das Alpaka Unsinn, ist das Gesagte schon gesichert.
Die Notiz, die daraus entsteht, enthält das Transkript unverändert. Das Alpaka darf zusammenfassen, Überschriften setzen und Projekte verlinken, aber nicht an deinen Worten herumglätten. Darauf verlassen wir uns nicht nur im Prompt: Ein Wächter im Backend prüft nach jedem KI-Lauf, ob das Transkript noch wortgetreu in der Notiz steht, und stellt es sonst wieder her.
Das Live-Transkript beim Sprechen kommt aus der Spracherkennung von Chrome, die über Google läuft. Ziehst du eine fertige Audiodatei hinein, geht sie an Google Speech-to-Text.
Nichts geht endgültig verloren
Löschen heißt in kontext: verschieben nach vault/.papierkorb/. Das gilt für dich und für das Alpaka. Und wenn die KI eine bestehende Datei überschreibt, landet die alte Version vorher ebenfalls im Papierkorb. Ein Agent, der Dateien bearbeiten darf, macht irgendwann einen Fehler. Die Frage ist nur, ob man ihn rückgängig machen kann.
Wer den Papierkorb leeren will, löscht den Ordner von Hand. Das ist Absicht.
Erinnerungen als lesbare Dateien
Erinnerungen und Push-Abos liegen als JSON-Dateien in vault/.kontext/. Ein Cron-Takt im Backend schaut alle 30 Sekunden nach, was fällig ist, und schickt die Push-Nachricht. Du kannst die Dateien öffnen, lesen und notfalls von Hand ändern. Die VAPID-Schlüssel, mit denen der Server Push-Nachrichten signiert, liegen getrennt in data/, außerhalb des Vaults. Wer den Vault teilt oder synchronisiert, gibt so keine Schlüssel mit weiter.
Warum keine Datenbank
Eine Datenbank wäre schneller gebaut gewesen. SQLite, eine Tabelle für Notizen, eine für Ordner, fertig. Wir haben uns aus vier Gründen dagegen entschieden:
- Portabel. Den Vault kannst du kopieren, zippen, auf einen USB-Stick ziehen. Du brauchst kontext nicht, um an deine Notizen zu kommen.
- Synchronisierbar. Ein Ordner mit Textdateien lässt sich mit git versionieren oder mit Syncthing zwischen Rechnern abgleichen. Mit git siehst du sogar, was das Alpaka wann geändert hat.
- Lesbar für andere Werkzeuge. Claude Code, Obsidian, VS Code oder jeder andere Editor können denselben Vault öffnen. kontext ist eine Ansicht auf deine Dateien, kein Gefängnis für sie.
- Datenschutz. Die Notizen liegen auf deinem Rechner. Pro Anfrage geht nur der Kontext, den das Alpaka dafür braucht, an die Claude API. Google bekommt nur Audio für die Spracherkennung. Es gibt keinen kontext-Server, auf dem alles gesammelt wird.
Die Datei ist die Wahrheit. Alles andere ist abgeleitet.
Dieser Satz entscheidet viele Detailfragen. Der Suchindex ist abgeleitet, also darf er im Arbeitsspeicher liegen. Der Dateiname ist aus der ersten Zeile abgeleitet, also gibt es kein separates Titelfeld, das auseinanderlaufen kann. Wer eine Datei außerhalb von kontext ändert, sieht die Änderung beim nächsten Laden.
Was im Browser bleibt (localStorage) und was nicht
Im Browser speichert kontext fast nichts. Im localStorage landen nur Bequemlichkeiten:
- welche Ordner aufgeklappt sind
- welche Notiz zuletzt offen war
Keine Notiz, kein Transkript, keine Erinnerung liegt dort. Jeder Zugriff auf localStorage steht in einem try/catch. Im privaten Fenster, mit blockiertem Speicher oder nach dem Löschen der Browserdaten startet kontext einfach mit zugeklappten Ordnern. Verloren ist dabei nichts, weil dort nichts Wichtiges lag.
| Was | Wo | Format |
|---|---|---|
| Notizen und Ordner | vault/ | Markdown in echten Ordnern |
| Regeln für die KI | _ki.md im jeweiligen Ordner | Markdown |
| Sprachnachrichten | vault/.audio/ | Audiodatei + Transkript als .txt |
| Gelöschtes, alte Versionen | vault/.papierkorb/ | die Originaldateien |
| Erinnerungen, Push-Abos | vault/.kontext/ | JSON |
| VAPID-Schlüssel | data/, außerhalb des Vaults | Schlüsseldatei |
| Suchindex | Arbeitsspeicher | wird aus den Dateien gebaut |
| Aufgeklappte Ordner, letzte Notiz | Browser, localStorage | optional, darf fehlen |
Grenzen
Diese Strategie hat Preise. Wir schreiben sie lieber hin, als dass du sie später selbst findest.
- Kein eingebauter Sync zwischen Geräten. Wer kontext auf Laptop und Desktop nutzen will, synchronisiert den Vault selbst, etwa mit git oder Syncthing. Konflikte löst dann dieses Werkzeug, nicht kontext.
- Keine gleichzeitige Bearbeitung. kontext ist für eine Person gebaut. Schreiben zwei Leute gleichzeitig in dieselbe Notiz, kann eine Änderung die andere überschreiben.
- Suche ohne Embeddings. BM25 findet Wörter, keine Bedeutungen. Wer nach „Rechnung“ sucht, findet „Faktura“ nicht. Für einige tausend Notizen und ein Gedächtnis für Stichworte reicht das. Für mehr wäre ein semantischer Index der nächste Schritt.
- Nicht ganz offline. Die Notizen sind lokal, das Alpaka und die Spracherkennung nicht. Ohne Internet schreibst du weiter, aber ohne KI und ohne Transkript.
Was wir daraus mitnehmen
Bei KI-Werkzeugen reden alle über Modelle und Prompts. Die Frage, wo die Daten liegen und wie man einen Fehler der KI rückgängig macht, entscheidet aber, ob man einem Werkzeug seine Gedanken anvertraut. Für uns heißt das: lesbare Dateien, ein Papierkorb, der nichts vergisst, und eine Sicherung, bevor die KI überhaupt anfängt.
Mehr zum Werkzeug selbst, mit Funktionen und Anleitung zum lokalen Start, steht auf der Seite zu kontext. Du willst es ausprobieren oder etwas Ähnliches für dein Team? Schreib uns.
Storing notes locally, in short
kontext is our browser-based note system with an AI agent called “Alpaka” and voice notes. Its storage strategy: the vault is a plain folder with real subfolders and Markdown files, no database. A _ki.md file holds rules for the AI and is inherited by subfolders. Search is an in-memory BM25 index rebuilt incrementally by file modification time. Voice notes are logged (audio plus verbatim transcript) before the AI runs, and a backend guard keeps the transcript unchanged in the note. Deleting moves files to a trash folder, and overwritten files are backed up there first. Reminders and push subscriptions are readable JSON files; VAPID keys live outside the vault. The browser only stores conveniences. Limits: no built-in device sync, no concurrent editing, no semantic search.