Two-Tower-Architektur: Zwei Türme, ein gemeinsamer Raum
Ein Begriff, zwei Welten. Im maschinellen Lernen steckt die Two-Tower-Architektur hinter fast jeder Empfehlung, die du heute siehst, hinter Produktsuche und hinter vielen RAG-Systemen. Im Bauwesen meint man damit Zwillingstürme. Dieser Guide erklärt beides, mit dem Schwerpunkt auf der KI-Seite: wie die zwei Türme funktionieren, warum sie so schnell sind, wie man sie trainiert, wo sie scheitern und wie du eins baust. Mit sieben Animationen und Code.
TL;DR
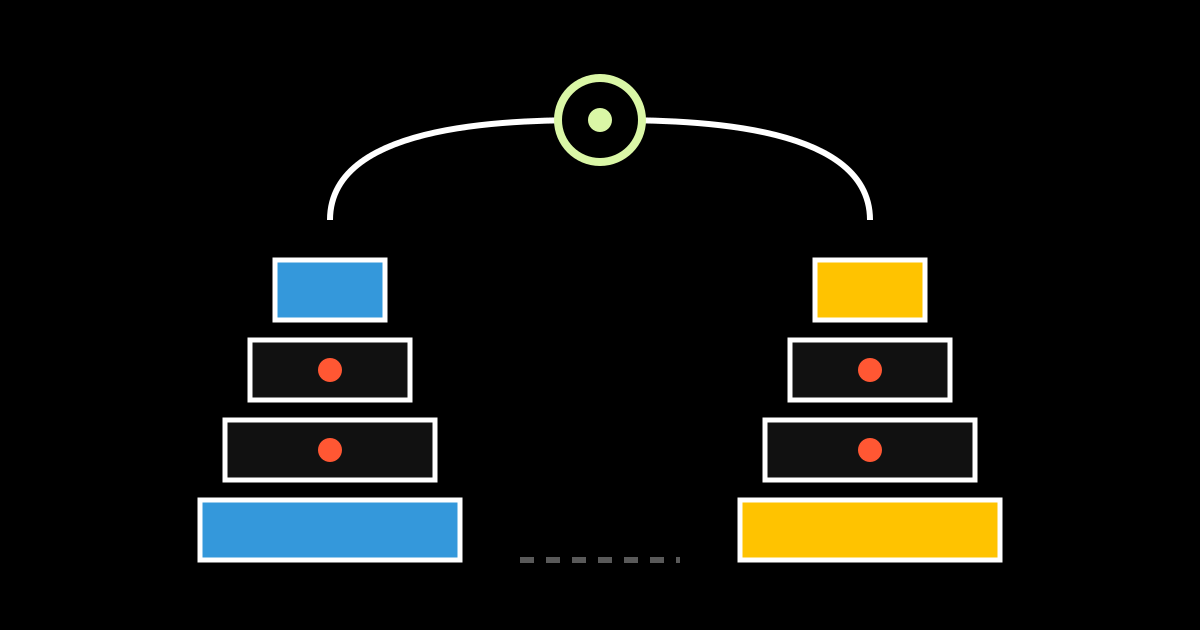
- Zwei Türme, zwei Seiten. Ein Netz macht aus der Anfrage einen Vektor, ein zweites aus dem Kandidaten. Das Skalarprodukt sagt, wie gut sie passen.
- Getrennt heißt schnell. Alle Kandidaten werden vorab gerechnet. Bei einer Anfrage läuft nur ein Turm, dann eine Vektorsuche. Millionen Einträge, Millisekunden.
- Training mit Paaren. Was zusammengehört, wird zusammengezogen. Die anderen Beispiele im Batch sind die Gegenbeispiele.
- Schnell, aber grob. Die Türme sehen sich nie gegenseitig. Deshalb folgt fast immer ein genaueres Ranking-Modell auf die Vorauswahl.
- Im Bauwesen heißen zwei Türme Zwillingstürme. Spannend sind dort Wind im Spalt und Brücken, die sich bewegen dürfen.
Entwicklerinnen, Produktleute und Neugierige, die verstehen wollen, wie Empfehlung und Suche heute gebaut werden.
Keins nötig. Was ein Vektor ist, erklären die Animationen. Für den Code hilft etwas Python.
Wie Vektorsuche Kontext für Sprachmodelle holt, steht in RAG erklärt.
Ein Begriff, zwei Welten
Wer „Two-Tower-Architektur“ sucht, landet entweder in Papers über Empfehlungssysteme oder bei Fotos von Hochhäusern. Beide Bedeutungen haben nichts miteinander zu tun, außer dem Bild von zwei Türmen nebeneinander.
Ein Modell aus zwei getrennten neuronalen Netzen, den Türmen. Eins für die Anfrage, eins für die Kandidaten. Auch Dual Encoder oder Bi-Encoder genannt.
Einsatz: Empfehlungen, Suche, RAG, Bild-Text-Suche.
Zwei Hochhäuser als ein Projekt, oft mit gemeinsamem Sockel und manchmal mit Brücke dazwischen. Deutsch meist Zwillingstürme oder Doppeltürme.
Geplant mit BIM- und Tragwerkssoftware, nicht mit einem Programm namens „Two Tower“.
Der Großteil dieses Guides gehört der KI-Seite, weil sie dort ein fester Fachbegriff ist und in vielen Projekten steckt, die wir bei VARTAKT bauen. Die Bauseite bekommt ein eigenes Kapitel am Ende: Two Tower im Bauwesen.
Das Problem: Millionen Kandidaten
Stell dir eine Plattform mit zehn Millionen Videos, Produkten oder Events vor. Eine Person öffnet die App, und innerhalb von etwa hundert Millisekunden soll eine Liste erscheinen, die zu ihr passt. Das heißt: Aus zehn Millionen Möglichkeiten müssen die besten paar Hundert gefunden werden, bevor das Display überhaupt fertig geladen ist.
Die naheliegende Lösung wäre ein großes Modell, das für jedes Paar aus Person und Kandidat sagt, wie gut es passt. Bei zehn Millionen Kandidaten heißt das zehn Millionen Modell-Aufrufe pro Seitenaufruf. Das ist zu langsam und zu teuer, egal wie viele Grafikkarten man kauft.
Die Idee der Two-Tower-Architektur: Man übersetzt beide Seiten getrennt in eine gemeinsame Sprache aus Zahlen, einen Vektor. Wie gut zwei Dinge zusammenpassen, ist dann nur noch eine Frage der Geometrie: Zeigen ihre Vektoren in dieselbe Richtung? Und weil die Kandidaten nicht von der Anfrage abhängen, kann man sie alle vorab übersetzen.
Wie die zwei Türme arbeiten
Jeder Turm ist ein eigenes neuronales Netz. Unten gehen Merkmale rein, oben kommt ein Vektor mit fester Länge raus, typischerweise 64 bis 1.024 Zahlen. Was die Merkmale sind, hängt vom Einsatz ab:
- Anfrage-Turm (auch Query- oder User-Turm): Suchtext, letzte Klicks, Ort, Uhrzeit, Gerät, Sprache.
- Kandidaten-Turm (auch Item- oder Dokument-Turm): Titel, Beschreibung, Kategorie, Preis, Bild, Ort, Datum.
Beide Türme dürfen völlig unterschiedlich gebaut sein. Ein Bild-Turm kann ein Vision-Modell sein, ein Text-Turm ein Sprachmodell. Wichtig ist nur, dass oben Vektoren derselben Länge rauskommen. Erst ganz am Ende treffen sich die beiden Seiten, in einer einzigen Rechnung: dem Skalarprodukt.
Animation 1 · Zwei Türme treffen sich oben
Das Skalarprodukt multipliziert die beiden Vektoren Stelle für Stelle und addiert alles. Zeigen sie in dieselbe Richtung, wird die Zahl groß. Stehen sie senkrecht, ist sie null. Zeigen sie in entgegengesetzte Richtungen, wird sie negativ. Teilt man noch durch die Längen der Vektoren, bekommt man den Kosinus, einen Wert zwischen minus eins und eins.
Der gemeinsame Raum
Nach dem Training wohnen Anfragen und Kandidaten im selben Raum. Ähnliche Dinge liegen nah beieinander, eine Person liegt nah bei dem, was sie mag. Echte Räume haben Hunderte Dimensionen, aber das Prinzip sieht man schon in zwei.
Ein Detail mit großer Wirkung: Skalarprodukt oder Kosinus? Das Skalarprodukt bezieht die Länge der Vektoren mit ein. Modelle lernen oft, beliebten Einträgen längere Vektoren zu geben. Dann gewinnt das Beliebte, auch wenn es inhaltlich nicht ganz so gut passt. Der Kosinus schaut nur auf die Richtung.
Animation 2 · Der gemeinsame Raum
Was die Dimensionen bedeuten, legt niemand fest. Das Modell findet die Richtungen selbst, die beim Trennen helfen. Manchmal lassen sie sich deuten, etwa als „elektronisch gegen akustisch“, meistens nicht. Das ist der Preis dafür, dass niemand Kategorien von Hand pflegen muss.
Warum es so schnell ist
Hier liegt der eigentliche Trick. Weil der Kandidaten-Turm nichts von der Anfrage weiß, kann man alle Kandidaten offline durch ihn schicken, zum Beispiel jede Nacht, und die Vektoren in einem Index speichern. Bei einer Anfrage passiert online nur noch zweierlei: Der Anfrage-Turm rechnet einen einzigen Vektor, und eine Vektorsuche findet die nächsten Nachbarn im Index.
Das Gegenmodell heißt Cross-Encoder. Er bekommt Anfrage und Kandidat zusammen und kann jedes Wort der einen Seite mit jedem Wort der anderen vergleichen. Das ist genauer, aber er muss für jedes Paar neu laufen.
Animation 3 · Rechenzeit pro Anfrage
Der Unterschied ist nicht ein bisschen schneller, sondern ein paar Zehnerpotenzen. Das ist der Grund, warum große Plattformen ohne diese Bauweise gar nicht personalisieren könnten.
Training mit Paaren
Zum Trainieren braucht man Paare, die zusammengehören: Nutzerin und das Video, das sie zu Ende geschaut hat. Suchanfrage und das Produkt, das gekauft wurde. Frage und die Textstelle mit der Antwort. Bild und seine Bildunterschrift. Solche Paare fallen in vielen Firmen ohnehin an, in Logs, Bestellungen und Klickdaten.
Schwieriger sind die Gegenbeispiele. Man kann nicht alle zehn Millionen anderen Kandidaten als „passt nicht“ markieren. Der verbreitete Trick heißt In-Batch Negatives: Man nimmt einen Stapel von Paaren, rechnet alle Anfragen und alle Kandidaten durch ihre Türme und vergleicht jede Anfrage mit jedem Kandidaten im Stapel. Richtig ist jeweils nur der eigene Partner, also die Diagonale. Alle anderen sind automatisch Gegenbeispiele, ganz ohne Extrarechnung.
Eine Softmax-Verlustfunktion macht daraus ein Ziel: In jeder Zeile soll die Diagonale die höchste Wahrscheinlichkeit bekommen. Die Temperatur regelt, wie scharf das Modell zwischen knapp daneben und richtig unterscheidet.
Animation 4 · In-Batch Negatives, echt gerechnet
Die Beliebtheits-Falle
In-Batch Negatives haben einen Haken. Beliebte Einträge stecken in vielen Paaren und tauchen deshalb oft als Gegenbeispiel auf. Das Modell lernt, sie zu bestrafen, nur weil sie häufig sind. Forschende bei Google haben das 2019 für YouTube beschrieben und eine Korrektur vorgeschlagen: Vom Wert jedes Kandidaten wird der Logarithmus seiner Stichproben-Wahrscheinlichkeit abgezogen. Diese logQ-Korrektur ist heute Standard.
Weitere Stellschrauben, die in der Praxis viel bringen:
- Harte Negative: Kandidaten, die fast passen, aber eben nicht. Das Rap-Konzert für jemanden, der Hip-Hop-Jams mag, aber nie zu großen Konzerten geht.
- Gemischte Negative: Neben dem Batch auch zufällige Einträge aus dem ganzen Katalog, damit seltene Einträge mitlernen.
- Gute Labels: Ein Klick ist schwächer als ein Kauf, ein Kauf schwächer als ein Wiederkauf. Was als positives Paar gilt, entscheidet, was das Modell optimiert.
Nächste Nachbarn finden
Auch mit fertigen Vektoren ist es teuer, eine Anfrage mit zehn Millionen Vektoren zu vergleichen. Deshalb nutzt man Approximate Nearest Neighbor-Suche, kurz ANN. Statt alle zu prüfen, prüft man nur die vielversprechenden Ecken des Raums und nimmt in Kauf, ab und zu einen Treffer zu übersehen.
Eine einfache Variante ist der invertierte Index (IVF): Man teilt den Raum vorab in Bereiche mit je einem Mittelpunkt. Bei einer Anfrage schaut man nur in die nächsten paar Bereiche. Wie viele, regelt ein Parameter, meist nprobe genannt. Weitere verbreitete Verfahren sind Graphen wie HNSW, bei denen man von Nachbar zu Nachbar springt, und Komprimierung der Vektoren mit Product Quantization.
Animation 5 · Vektorindex mit Bereichen
Fertige Bibliotheken nehmen dir das ab: FAISS von Meta, ScaNN von Google, hnswlib, dazu Vektordatenbanken wie Qdrant, Weaviate, Milvus oder die Erweiterung pgvector für PostgreSQL. Für ein paar Hunderttausend Einträge reicht oft schon pgvector in der Datenbank, die man ohnehin hat. Wie das mit Sprachmodellen zusammenspielt, steht im Beitrag zu RAG.
Retrieval, dann Ranking
Ein Two-Tower-Modell ist selten das letzte Wort. Es ist der schnelle, grobe erste Schritt in einem Trichter. Fast alle großen Empfehlungs- und Suchsysteme sind so gebaut, seit YouTube das 2016 in einem viel zitierten Paper beschrieben hat: erst Kandidaten holen, dann genau sortieren.
Animation 6 · Der Empfehlungs-Trichter
Die Arbeitsteilung ist sinnvoll: Das Two-Tower-Modell muss nur dafür sorgen, dass die richtigen Kandidaten überhaupt in der Vorauswahl landen. Für die genaue Reihenfolge ist das Ranking-Modell zuständig, das sich teure Merkmale leisten kann, weil es nur noch tausend statt zehn Millionen Einträge sieht. Gemessen wird der erste Schritt deshalb am Recall, der zweite an Maßen wie NDCG, die die Reihenfolge bewerten.
Grenzen und Fallen
Die Stärke ist zugleich die Schwäche: Die beiden Türme sehen sich nie. Alles, was man über das Zusammenspiel von Anfrage und Kandidat wissen müsste, muss in zwei Vektoren gepresst werden, bevor sie sich treffen.
| Problem | Was passiert | Was hilft |
|---|---|---|
| Keine Wechselwirkung | „Günstige Schuhe“ und „Schuhe, nicht günstig“ landen nah beieinander, weil Details zwischen den Seiten nicht verglichen werden | Ranking-Modell oder Cross-Encoder dahinter, Late Interaction wie ColBERT |
| Kaltstart | Neue Einträge ohne Klicks haben keinen guten Vektor, wenn der Turm nur mit IDs arbeitet | Inhaltsmerkmale in den Turm: Text, Bild, Kategorie, Ort |
| Beliebtheit | Bekanntes wird zu stark oder zu schwach empfohlen | logQ-Korrektur, Kosinus statt Skalarprodukt, Vielfalt im Re-Ranking |
| Veraltete Vektoren | Nach neuem Training passen alte Index-Vektoren nicht mehr zum neuen Anfrage-Turm | Index und Turm immer gemeinsam versionieren und tauschen |
| Rückkopplung | Das System lernt aus Klicks auf das, was es selbst gezeigt hat, und wird immer enger | Etwas Zufall einstreuen, Daten aus Suche und Empfehlung mischen |
| Fairness | Kleine Anbieter, Nischen oder neue Künstlerinnen kommen kaum in die Vorauswahl | Quoten und Regeln im Re-Ranking, Auswertung nach Gruppen |
Beispiele aus der Praxis
Die Bauweise ist älter als der aktuelle KI-Hype und steckt in Systemen, die du täglich benutzt.
| System | Turm 1 | Turm 2 | Wozu |
|---|---|---|---|
| DSSM, Microsoft 2013 | Suchanfrage | Titel der Webseite | Websuche, eins der ersten Zwei-Turm-Modelle mit Deep Learning |
| YouTube 2019 | Nutzerin und Kontext | Video | Kandidaten für Empfehlungen, mit logQ-Korrektur |
| Sentence-BERT 2019 | Satz | Satz | Ähnliche Sätze finden, beide Türme mit denselben Gewichten |
| DPR 2020 | Frage | Textabschnitt | Passende Stellen für Frage-Antwort-Systeme, Vorläufer heutiger RAG-Suche |
| CLIP, OpenAI 2021 | Text | Bild | Bilder per Text suchen, trainiert auf 400 Millionen Bild-Text-Paaren |
| Embedding-APIs heute | Anfrage | Dokument | Semantische Suche und RAG, oft mit getrennten Präfixen für Anfrage und Dokument |
Und in kleinen Firmen?
Man muss keine Plattform mit zehn Millionen Nutzern sein. Sobald ein Katalog zu groß zum Durchklicken ist, lohnt sich die Idee:
- Eventplattform: Personen und Events in einen Raum, Empfehlungen für das Wochenende, auch für neue Events über Genre, Ort und Beschreibung.
- Shop: Suche, die „Geschenk für Gärtnerin unter 30 Euro“ versteht, statt nur Wörter zu zählen.
- Kanzlei oder Praxis: Eine Anfrage findet die passenden Musterschreiben und internen Notizen, als Vorauswahl für Menschen.
- Recruiting: Stellen und Profile vorsortieren. Achtung: Personalauswahl ist nach EU AI Act Hochrisiko, hier entscheidet immer ein Mensch.
Oft braucht es dafür nicht mal ein eigenes Training. Ein fertiges Embedding-Modell für beide Seiten, pgvector in der Datenbank und gute Daten bringen viele Firmen schon weit. Ein eigenes Two-Tower-Training lohnt sich, wenn es Verhaltensdaten gibt, also Klicks, Käufe oder Buchungen, die zeigen, was wirklich passt.
Selbst bauen: Code
So sieht ein minimales Two-Tower-Modell in PyTorch aus. Zwei kleine Netze, normierte Vektoren und die In-Batch-Softmax aus Animation 4:
import torch, torch.nn as nn, torch.nn.functional as F

class Tower(nn.Module):
    def __init__(self, n_in, dim=64):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(n_in, 256), nn.ReLU(), nn.Linear(256, dim))
    def forward(self, x):
        return F.normalize(self.net(x), dim=-1)   # Länge 1, Skalarprodukt = Kosinus

user_tower = Tower(n_user_features)
item_tower = Tower(n_item_features)

def loss_fn(user_x, item_x, tau=0.05):
    u = user_tower(user_x)                      # (B, 64)
    v = item_tower(item_x)                      # (B, 64)
    logits = u @ v.T / tau                      # (B, B): jede Person gegen jedes Item
    labels = torch.arange(len(u))               # richtig ist die Diagonale
    return F.cross_entropy(logits, labels)
Und so wird es ausgeliefert: Kandidaten einmal offline rechnen, Anfragen online.
import faiss

with torch.no_grad():
    item_vecs = item_tower(all_item_x).numpy()      # offline, z. B. jede Nacht
index = faiss.IndexHNSWFlat(64, 32)                 # Graph-Index, 32 Nachbarn je Knoten
index.add(item_vecs)                                # bei Länge 1 ordnet L2 wie Kosinus

with torch.no_grad():
    q = user_tower(current_user_x).numpy()          # online, ein Vektor
dist, ids = index.search(q, 100)                    # 100 Kandidaten fürs Ranking
Für die logQ-Korrektur zieht man vor der Softmax von jeder Spalte log(p_j) ab, wobei p_j geschätzt wird, wie oft Item j in Batches auftaucht. Fertige Bausteine dafür gibt es in TensorFlow Recommenders und TorchRec.
Wenn du mit fertigen Modellen startest statt selbst zu trainieren, ist das Two-Tower-Prinzip dasselbe: Ein Embedding-Modell rechnet Dokumente beim Speichern und Anfragen bei der Suche. Wie das in Agenten-Systeme passt, steht in Agentische Systeme.
Two Tower im Bauwesen
Jetzt zur anderen Bedeutung. Im Bauwesen ist „Two Tower“ kein fester Fachbegriff für eine Software, sondern beschreibt eine Bauform: zwei Türme, die als ein Projekt geplant werden. Auf Deutsch sagt man meist Zwillingstürme oder Doppeltürme.
| Bauwerk | Ort, Jahr | Höhe | Besonderheit |
|---|---|---|---|
| World Trade Center | New York, 1971 und 1973 | 417 und 415 m | Tragende Außenwand als Röhre, 2001 bei den Anschlägen zerstört |
| Deutsche-Bank-Türme | Frankfurt, 1984 | je 155 m | Spitzname „Soll und Haben“, 2007 bis 2011 energetisch saniert |
| Petronas Towers | Kuala Lumpur, 1998 | 452 m | Bis 2004 höchste Gebäude der Welt, Skybridge im 41. und 42. Stock |
| Bosco Verticale | Mailand, 2014 | rund 111 und 76 m | Hunderte Bäume auf den Balkonen, Vorbild für begrünte Hochhäuser |
Was zwei Türme schwierig macht
- Wind im Spalt: Zwischen zwei nahen Hochhäusern kann der Wind beschleunigen, und die Wirbel des einen Turms treffen den anderen. Fachleute sprechen von Interferenz. Geprüft wird das im Windkanal und mit Strömungssimulation.
- Die Brücke: Zwei Türme schwanken unterschiedlich. Eine starr befestigte Brücke würde reißen oder die Türme verbinden, ohne dass sie dafür bemessen sind. Die Skybridge der Petronas Towers ist deshalb beweglich gelagert und kann den Bewegungen folgen.
- Gemeinsamer Sockel: Ein Sockel, zwei Türme mit eigenen Lasten. Setzungen und Fugen müssen zusammen geplant werden.
- Brandschutz und Flucht: Eine Brücke kann ein zusätzlicher Fluchtweg sein, braucht aber eigene Konzepte.
Animation 7 · Zwei Türme im Wind
Womit man so etwas plant
Wenn mit „Two-Tower-Software“ Planungswerkzeuge gemeint sind, dann sind das die üblichen Programme für Hochbau und Tragwerk, nicht ein Spezialprogramm:
- BIM-Modellierung: Autodesk Revit, Graphisoft Archicad, Nemetschek Allplan. Gebäude als digitales Modell mit Bauteilen statt Linien.
- Austausch: IFC als offenes Format (ISO 16739), damit Architektur, Tragwerk und Haustechnik am selben Modell arbeiten.
- Tragwerk: Programme wie RFEM von Dlubal oder ETABS rechnen Lasten, Schwingungen und Erdbeben.
- Wind: Windkanalversuche mit Modellen und Strömungssimulation (CFD).
Eine schöne Brücke zur KI-Seite gibt es trotzdem: Auch in der Bauplanung werden Embeddings genutzt, etwa um in großen Bauteil-Katalogen, Normen oder alten Projektunterlagen ähnliche Fälle zu finden. Das ist dann wieder ein Two-Tower-Modell, nur ohne Beton.
Welche Bedeutung ist gemeint?
- Steht daneben Embedding, Retrieval, Recommender, Vektor oder Query: maschinelles Lernen.
- Steht daneben Tragwerk, Geschosse, Skybridge, BIM oder Fassade: Bauwesen.
- Im Zweifel: In Stellenanzeigen und Tech-Blogs ist fast immer die KI-Bedeutung gemeint.
Häufige Fragen
Was ist eine Two-Tower-Architektur?
Ein Modell aus zwei getrennten neuronalen Netzen. Eins macht aus der Anfrage einen Vektor, eins aus dem Kandidaten. Das Skalarprodukt der beiden Vektoren sagt, wie gut sie passen. Andere Namen: Dual Encoder, Bi-Encoder.
Warum ist das so schnell?
Weil die Kandidaten vorab durch ihren Turm gerechnet und in einem Vektorindex gespeichert werden. Bei einer Anfrage läuft nur der Anfrage-Turm, dann eine Nachbarsuche. Das dauert auch bei Millionen Einträgen nur Millisekunden.
Two-Tower oder Cross-Encoder?
Beides. Two-Tower für die schnelle Vorauswahl aus allem, Cross-Encoder oder Ranking-Modell für die genaue Reihenfolge der besten paar Hundert.
Wie trainiert man das?
Mit Paaren, die zusammengehören. Die anderen Beispiele im Batch sind die Gegenbeispiele. Eine Softmax zieht passende Paare zusammen und drückt unpassende auseinander. Die logQ-Korrektur gleicht aus, dass beliebte Einträge öfter als Gegenbeispiel auftauchen.
Und im Bauwesen?
Dort meint man Zwillingstürme wie die Petronas Towers. Geplant wird mit BIM- und Tragwerkssoftware, besondere Themen sind Wind zwischen den Türmen und bewegliche Brücken.
Quellen
- Po-Sen Huang u. a.: Learning Deep Structured Semantic Models for Web Search using Clickthrough Data. CIKM 2013.
- Paul Covington, Jay Adams, Emre Sargin: Deep Neural Networks for YouTube Recommendations. RecSys 2016.
- Xinyang Yi u. a.: Sampling-Bias-Corrected Neural Modeling for Large Corpus Item Recommendations. RecSys 2019.
- Nils Reimers, Iryna Gurevych: Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP 2019.
- Vladimir Karpukhin u. a.: Dense Passage Retrieval for Open-Domain Question Answering. EMNLP 2020.
- Omar Khattab, Matei Zaharia: ColBERT: Efficient and Effective Passage Search via Contextualized Late Interaction over BERT. SIGIR 2020.
- Alec Radford u. a.: Learning Transferable Visual Models From Natural Language Supervision (CLIP). ICML 2021.
- Jeff Johnson, Matthijs Douze, Hervé Jégou: Billion-scale similarity search with GPUs (FAISS). IEEE Transactions on Big Data, 2019.
- Yu. A. Malkov, D. A. Yashunin: Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs. IEEE TPAMI, 2020.
- Ruiqi Guo u. a.: Accelerating Large-Scale Inference with Anisotropic Vector Quantization (ScaNN). ICML 2020.
- ISO 16739: Industry Foundation Classes (IFC)
Weiterlesen
- RAG erklärt: Wie der Kontext geholt wird
- KI-Automatisierung: Was sich lohnt und wie du anfängst
- Agentische Systeme: Wie Markdown Claude Code steuert
- Neueste Ansätze bei KI-Agenten
In short
"Two-tower architecture" means two unrelated things. In machine learning, it is a model made of two separate neural networks: one encodes the query or user, the other encodes the candidate item, document or image, and their dot product or cosine scores the match. Because the towers never interact, all candidates can be encoded offline and stored in a vector index; at request time only the query tower runs, followed by an approximate nearest neighbor search (IVF, HNSW, FAISS, ScaNN, pgvector), which scales to millions of items within milliseconds. Training uses positive pairs with in-batch negatives and a softmax loss, usually with a temperature and the logQ correction for popularity bias described by Google for YouTube in 2019. The weakness is the missing interaction between both sides, so retrieval is followed by a ranking model or cross-encoder. Further pitfalls are cold start, popularity, stale index vectors and feedback loops. Examples include DSSM, YouTube, Sentence-BERT, DPR and CLIP; the post includes seven interactive animations and PyTorch and FAISS code. In construction, the term refers to twin towers such as the Petronas Towers or Frankfurt's Deutsche Bank towers, planned with BIM and structural software, with wind interference and movable skybridges as special challenges.