News Brain: Unser Blog als Gehirn
Wir haben alle Blogposts in Vektoren verwandelt und in eine Vektordatenbank gelegt. Jetzt sieht man, welche Gedanken zusammengehören, auch wenn wir sie nie verlinkt haben.
Was du siehst
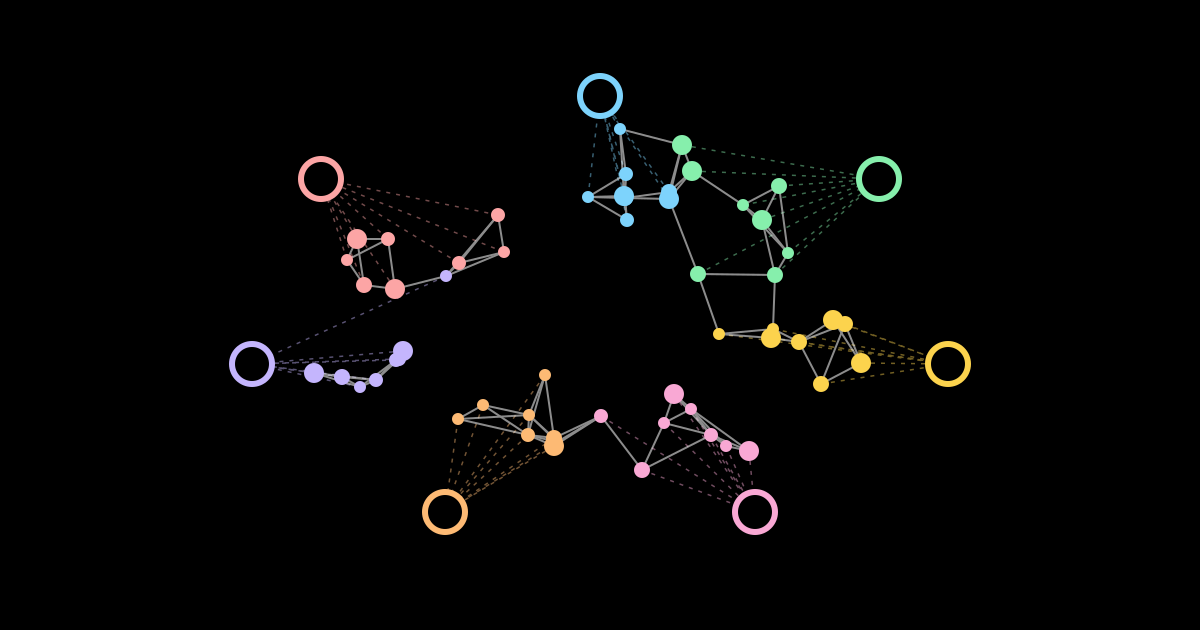
Auf vartakt.com/news-brain ist jeder Beitrag aus unserem Blog ein Punkt. Linien verbinden Beiträge, die sich inhaltlich ähneln. Die großen Ringe sind sieben Überkategorien: KI & Agenten, Kopf & Körper, Bücher, Gründen & Produkt, Technik & Werkzeuge, Kunst & Reisen und VARTAKT intern.
Klickst du einen Punkt an, fragt die Seite live die Vektordatenbank nach seinen fünf nächsten Nachbarn. Nichts davon ist von Hand verlinkt. Die Nähe kommt aus der Mathematik.
Was ein Embedding ist
Ein Embedding-Modell macht aus einem Text eine Liste von Zahlen, einen Vektor. Texte mit ähnlicher Bedeutung landen nah beieinander, auch wenn sie andere Wörter benutzen. Der Post über Stress im Gehirn liegt deshalb neben dem über Achtsamkeit, obwohl sie kaum ein Wort teilen.
Wie nah, misst die Kosinus-Ähnlichkeit: 1 heißt gleiche Richtung, 0 heißt nichts gemeinsam. Das gleiche Prinzip steckt hinter RAG und hinter der Two-Tower-Architektur.
Die Pipeline
Text wird auf dem Laptop zum Vektor. Der Server speichert und vergleicht nur.
- Sammeln. Ein Skript liest alle Beiträge aus der News-Liste und zieht den Artikeltext aus dem HTML, ohne Skripte, Grafiken und Navigation.
- Embedden. Auf meinem Laptop läuft
qwen3-embedding:4büber Ollama. Das Modell steht in mehrsprachigen Benchmarks weit oben, und versteht Deutsch gut. Pro Post nimmt es die ersten rund 4000 Token, das reicht für das Thema. Heraus kommt ein Vektor mit 4096 Zahlen. - Hochladen. Die Vektoren gehen an eine kleine API auf unserem Server. Sie schreibt in Qdrant, eine Open-Source-Vektordatenbank. Qdrant selbst hängt nicht offen im Netz.
- Verbinden. Für den Graphen rechnet Qdrant mit seiner Distanzmatrix für jeden Post die fünf nächsten Nachbarn aus. Dazu kommen die Kanten zu den Überkategorien.
Warum auf dem Laptop
Der Server muss kein großes Modell im Speicher halten, und es fallen keine API-Kosten an. Die Texte sind ohnehin öffentlich, aber der Ablauf funktioniert genauso mit internen Dokumenten, die das Haus nicht verlassen sollen.
Der erste Lauf über alle 56 Beiträge dauerte knapp eine Stunde, nebenbei liefen acht weitere KI-Sessions auf demselben Laptop. Mit dem 8B-Modell wären es über drei Stunden gewesen, deshalb rechnet hier die 4B-Variante: Sie liegt im Benchmark fast gleichauf. Danach geht es schnell: Das Skript speichert pro Post einen Fingerabdruck des Textes und embeddet nur, was neu ist oder sich geändert hat.
Neue Posts kommen von selbst rein
Der Sync hängt am Build der Webseite. Wer einen Beitrag schreibt und baut, schickt ihn mit ins Gehirn. Läuft Ollama gerade nicht, warnt der Build nur und macht weiter. Den Rest holt npm run brain:sync nach.
npm run brain:sync -- --dry    # zeigt, was sich ändern würde
npm run brain:sync             # neue und geänderte Posts embedden
npm run brain:sync -- --force  # alles neu, z. B. nach Modellwechsel
Wechselt das Modell und damit die Zahl der Dimensionen, legt die API die Sammlung neu an und alles wird neu berechnet. Alte und neue Vektoren mischen sich so nie.
Was es nicht kann
- Nähe ist keine Wahrheit. Zwei Posts können ähnlich klingen und verschiedene Dinge meinen.
- Kurze Texte wie die alten Reisetagebuch-Einträge haben wenig Signal und hängen lockerer im Netz.
- Die Überkategorien vergebe ich nach Regeln über die Tags. Das Modell bestätigt sie meistens, aber nicht immer. Genau das ist spannend zu sehen.
Die Seite ist ein Test. Wenn sie trägt, wird daraus eine Leseempfehlung unter jedem Beitrag: „Das könnte dich auch interessieren“, direkt aus der Datenbank.
Du willst so etwas für deine eigenen Dokumente? Schreib uns.
Quellen
In short
Every VARTAKT blog post is embedded locally with Qwen3-Embedding 4B via Ollama and stored in Qdrant on our server. The test page /news-brain draws the posts as a network: lines connect similar posts, rings are the seven main categories. New posts are embedded incrementally during the site build.